2021了你还不知道数据标注?人工智能为什么需要数据标注
2021年,人工智能已经渗透到我们生活的方方面面,从智能语音助手到自动驾驶汽车,从个性化推荐到医疗影像诊断。在这些光鲜亮丽的应用背后,有一个不可或缺却鲜为人知的环节——数据标注。如果你还不知道数据标注是什么,那么是时候了解一下这个支撑人工智能发展的基础工作了。
什么是数据标注?
简单来说,数据标注就是对原始数据进行加工处理,打上标签,使其成为机器可以理解和学习的结构化数据。人工智能模型,尤其是深度学习模型,需要大量的标注数据来训练。例如,要让机器识别猫和狗,就需要先提供成千上万张标注了“猫”或“狗”的图片;要让语音助手听懂人话,就需要大量的语音数据并标注对应的文字。数据标注是人工智能的“老师”,它就像是教小孩子认字时用的图卡,告诉机器“这是什么”。
人工智能为什么需要数据标注?
人工智能的核心是机器学习,而机器学习依赖于数据。没有高质量的数据,再先进的算法也是无米之炊。具体来说,数据标注在人工智能中扮演着以下几个关键角色:
- 提供监督学习的“标准答案”:大多数AI模型采用监督学习方式,即通过输入数据和对应的标签来学习映射关系。标注数据就是给机器的“标准答案”,使模型能够计算误差并逐步优化。
- 提升模型精度和鲁棒性:标注数据的数量和质量直接决定了模型的性能上限**。覆盖多样场景的标注数据能帮助模型更好地泛化到真实世界。
- 应对特定领域的复杂性:在医疗、金融、法律等专业领域,通用数据无法满足需求,需要领域专家进行精细标注,从而使AI具备专业能力。
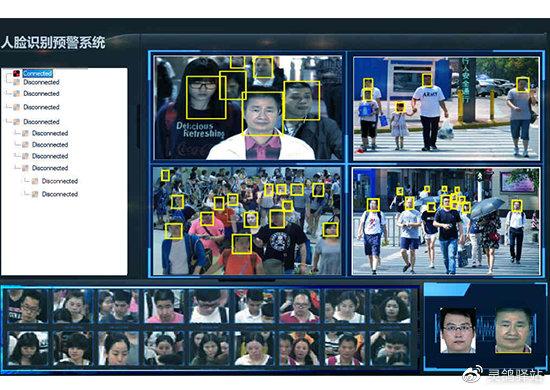
- 推动AI应用落地:无论是人脸识别、自动驾驶还是智能客服,每一款成功落地的AI产品背后都有海量的标注数据作为支撑。
公共数据在数据标注中的价值
随着人工智能对数据需求的激增,公共数据逐渐成为数据标注的重要来源。政府开放的公共数据集、学术机构发布的基准数据集、非营利组织共享的行业数据等,都为AI训练提供了丰富的素材。公共数据的开放共享可以降低AI研发门槛,促进创新,同时通过众包标注等方式,公共数据也能被高效利用。例如,许多自然语言处理模型就是基于公开的标注语料(如维基百科、新闻语料库)训练而成的。
###
2021年,人工智能正加速发展,而数据标注作为AI的“燃料”和“老师”,其重要性不言而喻。无论是从业者还是普通用户,了解数据标注的基本概念和必要性,有助于我们更好地理解人工智能的运作逻辑和局限性。随着标注工具和平台的智能化,数据标注的效率将不断提升,但人的判断和专业知识仍然是不可或缺的。下一次当你惊叹AI的神奇时,不妨想想背后那些默默奉献的标注工作者和公共数据集。
最新产品